Die Server-Verwaltung YunoHost ist eine großartige Sache. Seinen Server mit YunoHost zu verwalten erleichtert vieles. Ein E-Mail Server ist in der Grundausstattung bereits drin, ebenso wie ein Webserver. Man muss sich nicht mit der Einrichtung und Verwaltung eines Reverse-Proxy herumschlagen, Domains sind im Handumdrehen integriert und das auch gleich mit Let's Encrypt Zertifikat, welches vom System regelmäßig rechtzeitig erneuert wird. Backups? Kein Problem! ...
View article
View summary
Die Server-Verwaltung YunoHost ist eine großartige Sache. Seinen Server mit YunoHost zu verwalten erleichtert vieles. Ein E-Mail Server ist in der Grundausstattung bereits drin, ebenso wie ein Webserver. Man muss sich nicht mit der Einrichtung und Verwaltung eines Reverse-Proxy herumschlagen, Domains sind im Handumdrehen integriert und das auch gleich mit Let's Encrypt Zertifikat, welches vom System regelmäßig rechtzeitig erneuert wird. Backups? Kein Problem!
Das Beste an YunoHost ist aber die Möglichkeit, aus einem Katalog von hunderten Server-Anwendungen, seine eigenen Dienste mit wenig Aufwand zu installieren und zu verwalten.
Der App-Katalog ist inzwischen echt gigantisch und bietet alles, was das Herz begehrt.
All diese Apps werden von ehrenamtlichen Helfern betreut, die sich um die Installations-, Deinstallations- und Update-Skripte kümmern. Und sehr viele Anwendungen werden auch echt gut betreut. Updates kommen zeitnah und Fehler werden rasch beseitigt.
Ich selbst benutze YunoHost unter anderem dafür, einen meiner Hubzilla-Hubs zu betreiben. Ursprünglich habe ich ihn als YunoHost App betrieben. Im Frühjahr 2024 aber war ich es leid, dass Updates der App immer deutlich, und zu diesem Zeitpunkt sogar drastisch hinterherhinkten. Weil ich aber die Vorteile von YunoHost schätze und ich auch noch einige andere Dienste damit betreibe, wollte ich auf Hubzilla dort auch nicht verzichten. Also habe ich Hubzilla dann "zu Fuß" installiert... in der YunoHost App "My Webapp", die einen Webserver mit PHP und Datenbank zur Verfügung stellt. Das war kein großer Aufwand und ließ sich einfach erledigen. Wenn man sich an der Installationsanleitung von Hubzilla (core/install/INSTALL.txt) hält, ist es gut hinzubekommen. Lediglich die Konfiguration des Webservers (YunoHost verwendet Nginx anstelle von Apache) muss man etwas anpassen... dann passt's schon.
Der Vorteil bei der Sache: Ich kann den Komfort von YunoHost weiter nutzen... z.B. für Backups.
Zwischenzeitlich hatte sich der Update-Rhythmus der Hubzilla App bei YunoHost aber auch wieder verbessert. Eine ganze Zeit lang kamen Updates sehr zeitnah zu den Updates des eigentlichen Projektes. Ob das immer so war, weiß ich allerdings nicht, weil ich die App seit meinem Umzug zur My Webapp nicht mehr regelmäßig daraufhin angeschaut habe. Wenn ich aber mal geschaut habe, war es ganz ok. Und das, obwohl Hubzilla bei YunoHost wohl keinen echten festen Betreuer hat.
Und so habe ich dann auch die YunoHost App wieder empfohlen, wenn jemand ohne große Kenntnisse einen eigenen Hub aufsetzen wollte.
Das muss ich aber leider revidieren. Ich kann es echt nicht mehr empfehlen! Denn inzwischen hängt die App wieder extrem hinter der Original-Version. Heute, am 3. April 2026 ist die Version der YunoHost Hubzilla App 10.6.1, während die aktuelle Hubzilla-Version schon vor gut einer Woche bei 11.2 angekommen war. Die Version der App ist also über vier Monate alt. Damit fehlen einem Hub, der als App betrieben wird, auch etliche neue Features und diverse Fehlerbereinigungen sind natürlich auch noch nicht vorhanden.
Ein, zwei, drei Wochen... ja vielleicht, wenn es ein großes Update ist meinetwegen auch ein Monat... das würde ich noch als akzeptabel ansehen. Aber vier Monate sind echt zu viel, um die App noch guten Gewissens empfehlen zu können.
Schade, es scheint auch wirklich nur daran zu liegen, dass es keinen festen Betreuer für die App gibt. Pull-Requests und Testläufe sind immer sehr schnell da. Es fehlt nur derjenige, der den Hut auf hat und die App endgültig updatet. Ich wurde auch schon einmal gefragt, ob ich das übernehmen wolle. Aber ganz ehrlich... das pack ich nicht auch noch. Es ist ja nicht damit getan, irgendwie den Daumen nach oben zu recken. Man zeichnet ja dann auch für die App und deren Korrektheit verantwortlich. Ich müsste mich also erst in die ganze App-Verwalterei, die Systematik etc. bei YunoHost einarbeiten. Und das wäre jetzt echt zu viel, auch dies noch zu übernehmen. Dafür habe ich zu viele Baustellen oder Steckenpferde. Ich hänge schon bei der Hubzilla-Doku ein wenig zurück. Und dann arbeite ich mich nebenbei auch noch immer weiter in den Code von Hubzilla ein, um vielleicht irgendwann hier oder da mal mit Kleinigkeiten aushelfen zu können. Und jetzt habe ich auch noch "Addon-Blut" geleckt... und mir vorgenommen, irgendwann in diesem Jahr ein Addon zu präsentieren, mit welchem man WordPress-Artikel (samt Kommentaren) aus einer Sicherungsdatei in die Hubzilla Artikel-App zu übernehmen.
Dazu noch jeden Monat auch noch ein Hubzilla-Workshop, den irgendwie auch überwiegend ich vorbereiten muss. Dann auch noch meine eigenen "Werke für und zur Hubzilla-Dokumentation".
Jetzt aktuell steht bei mir auch noch ein geordneter Server-Umzug samt Hosterwechsel an, der sich über Wochen hinziehen wird.
Ach ja... und Frühling is'. Und Garten! Und am Haus ist auch immer was zu tun. Der Offenstall braucht dringend Reparaturen. Die Pferdkoppel braucht einen neuen Zaun. Dann unser Hunde-Altersheim... das möchte auch Zeit haben.
Also um die YunoHost App kann ich mich persönlich beim besten Willen nicht auch noch kümmern.
Aber so schlimm ist das auch nicht, denn Hubzilla geht ja prima mit YunoHost in der My Webapp. Und Hubzilla ist wirklich recht einfach zu installieren. Den grundsätzlichen Weg hab ich ja aufgeschrieben: Hubzilla mit einem YunoHost-Server betreiben / Running Hubzilla with a YunoHost server. Das sollte also jeder hinbekommen. Und für Fragen (auch dazu) bin ich jederzeit offen. Gerne auch im Kanal "Pepes Hubzilla-Sprechstunde" (hubzillasprechstunde@hub.hubzilla.hu).
Fazit: Hubzilla mit YunoHost? Ja! Aber nicht mit der Hubzilla-App, sondern mit der App "My Webapp"!
Die Server-Verwaltung YunoHost ist eine großartige Sache. Seinen Server mit YunoHost zu verwalten erleichtert vieles. Ein E-Mail Server ist in der Grundausstattung bereits drin, ebenso wie ein Webserver. Man muss sich nicht mit der Einrichtung und Verwaltung eines Reverse-Proxy herumschlagen, Domains sind im Handumdrehen integriert und das auch gleich mit Let's Encrypt Zertifikat, welches vom System regelmäßig rechtzeitig erneuert wird. Backups? Kein Problem! ...
View article
View summary
Die Server-Verwaltung YunoHost ist eine großartige Sache. Seinen Server mit YunoHost zu verwalten erleichtert vieles. Ein E-Mail Server ist in der Grundausstattung bereits drin, ebenso wie ein Webserver. Man muss sich nicht mit der Einrichtung und Verwaltung eines Reverse-Proxy herumschlagen, Domains sind im Handumdrehen integriert und das auch gleich mit Let's Encrypt Zertifikat, welches vom System regelmäßig rechtzeitig erneuert wird. Backups? Kein Problem!
Das Beste an YunoHost ist aber die Möglichkeit, aus einem Katalog von hunderten Server-Anwendungen, seine eigenen Dienste mit wenig Aufwand zu installieren und zu verwalten.
Der App-Katalog ist inzwischen echt gigantisch und bietet alles, was das Herz begehrt.
All diese Apps werden von ehrenamtlichen Helfern betreut, die sich um die Installations-, Deinstallations- und Update-Skripte kümmern. Und sehr viele Anwendungen werden auch echt gut betreut. Updates kommen zeitnah und Fehler werden rasch beseitigt.
Ich selbst benutze YunoHost unter anderem dafür, einen meiner Hubzilla-Hubs zu betreiben. Ursprünglich habe ich ihn als YunoHost App betrieben. Im Frühjahr 2024 aber war ich es leid, dass Updates der App immer deutlich, und zu diesem Zeitpunkt sogar drastisch hinterherhinkten. Weil ich aber die Vorteile von YunoHost schätze und ich auch noch einige andere Dienste damit betreibe, wollte ich auf Hubzilla dort auch nicht verzichten. Also habe ich Hubzilla dann "zu Fuß" installiert... in der YunoHost App "My Webapp", die einen Webserver mit PHP und Datenbank zur Verfügung stellt. Das war kein großer Aufwand und ließ sich einfach erledigen. Wenn man sich an der Installationsanleitung von Hubzilla (core/install/INSTALL.txt) hält, ist es gut hinzubekommen. Lediglich die Konfiguration des Webservers (YunoHost verwendet Nginx anstelle von Apache) muss man etwas anpassen... dann passt's schon.
Der Vorteil bei der Sache: Ich kann den Komfort von YunoHost weiter nutzen... z.B. für Backups.
Zwischenzeitlich hatte sich der Update-Rhythmus der Hubzilla App bei YunoHost aber auch wieder verbessert. Eine ganze Zeit lang kamen Updates sehr zeitnah zu den Updates des eigentlichen Projektes. Ob das immer so war, weiß ich allerdings nicht, weil ich die App seit meinem Umzug zur My Webapp nicht mehr regelmäßig daraufhin angeschaut habe. Wenn ich aber mal geschaut habe, war es ganz ok. Und das, obwohl Hubzilla bei YunoHost wohl keinen echten festen Betreuer hat.
Und so habe ich dann auch die YunoHost App wieder empfohlen, wenn jemand ohne große Kenntnisse einen eigenen Hub aufsetzen wollte.
Das muss ich aber leider revidieren. Ich kann es echt nicht mehr empfehlen! Denn inzwischen hängt die App wieder extrem hinter der Original-Version. Heute, am 3. April 2026 ist die Version der YunoHost Hubzilla App 10.6.1, während die aktuelle Hubzilla-Version schon vor gut einer Woche bei 11.2 angekommen war. Die Version der App ist also über vier Monate alt. Damit fehlen einem Hub, der als App betrieben wird, auch etliche neue Features und diverse Fehlerbereinigungen sind natürlich auch noch nicht vorhanden.
Ein, zwei, drei Wochen... ja vielleicht, wenn es ein großes Update ist meinetwegen auch ein Monat... das würde ich noch als akzeptabel ansehen. Aber vier Monate sind echt zu viel, um die App noch guten Gewissens empfehlen zu können.
Schade, es scheint auch wirklich nur daran zu liegen, dass es keinen festen Betreuer für die App gibt. Pull-Requests und Testläufe sind immer sehr schnell da. Es fehlt nur derjenige, der den Hut auf hat und die App endgültig updatet. Ich wurde auch schon einmal gefragt, ob ich das übernehmen wolle. Aber ganz ehrlich... das pack ich nicht auch noch. Es ist ja nicht damit getan, irgendwie den Daumen nach oben zu recken. Man zeichnet ja dann auch für die App und deren Korrektheit verantwortlich. Ich müsste mich also erst in die ganze App-Verwalterei, die Systematik etc. bei YunoHost einarbeiten. Und das wäre jetzt echt zu viel, auch dies noch zu übernehmen. Dafür habe ich zu viele Baustellen oder Steckenpferde. Ich hänge schon bei der Hubzilla-Doku ein wenig zurück. Und dann arbeite ich mich nebenbei auch noch immer weiter in den Code von Hubzilla ein, um vielleicht irgendwann hier oder da mal mit Kleinigkeiten aushelfen zu können. Und jetzt habe ich auch noch "Addon-Blut" geleckt... und mir vorgenommen, irgendwann in diesem Jahr ein Addon zu präsentieren, mit welchem man WordPress-Artikel (samt Kommentaren) aus einer Sicherungsdatei in die Hubzilla Artikel-App zu übernehmen.
Dazu noch jeden Monat auch noch ein Hubzilla-Workshop, den irgendwie auch überwiegend ich vorbereiten muss. Dann auch noch meine eigenen "Werke für und zur Hubzilla-Dokumentation".
Jetzt aktuell steht bei mir auch noch ein geordneter Server-Umzug samt Hosterwechsel an, der sich über Wochen hinziehen wird.
Ach ja... und Frühling is'. Und Garten! Und am Haus ist auch immer was zu tun. Der Offenstall braucht dringend Reparaturen. Die Pferdkoppel braucht einen neuen Zaun. Dann unser Hunde-Altersheim... das möchte auch Zeit haben.
Also um die YunoHost App kann ich mich persönlich beim besten Willen nicht auch noch kümmern.
Aber so schlimm ist das auch nicht, denn Hubzilla geht ja prima mit YunoHost in der My Webapp. Und Hubzilla ist wirklich recht einfach zu installieren. Den grundsätzlichen Weg hab ich ja aufgeschrieben: Hubzilla mit einem YunoHost-Server betreiben / Running Hubzilla with a YunoHost server. Das sollte also jeder hinbekommen. Und für Fragen (auch dazu) bin ich jederzeit offen. Gerne auch im Kanal "Pepes Hubzilla-Sprechstunde" (hubzillasprechstunde@hub.hubzilla.hu).
Fazit: Hubzilla mit YunoHost? Ja! Aber nicht mit der Hubzilla-App, sondern mit der App "My Webapp"!
...dass die Tage immer länger werden.
Nein, damit meine ich nicht die jahreszeitbedingt längeren Tage (Tag länger, Nacht kürzer), sondern dass ein ganzer Tag samt Nacht gefühlt immer länger dauert... so im Vergleich zu vor einem Jahr...
View article
View summary
...dass die Tage immer länger werden.
Nein, damit meine ich nicht die jahreszeitbedingt längeren Tage (Tag länger, Nacht kürzer), sondern dass ein ganzer Tag samt Nacht gefühlt immer länger dauert... so im Vergleich zu vor einem Jahr.
Und tatsächlich haben Forscher herausgefunden, dass dem wirklich so ist! Weil Klimawandel! Also weil Erwärmung!
Da schmelzen die Polkappen ab und es gibt mehr flüssiges Wasser, was die Rotationsgeschwindigkeit abbremst. Und das jetzt so schnell, wie seit gut 3,6 Millionen Jahren nicht mehr.
Deshalb schreibt Telepolis auch
Klimawandel macht unsere Tage länger – messbar (arch)
Und das um wahnsinnige 1,33 Millisekunden alle hundert Jahre!
Das sind pro Tag dann 0,00003643835616438356 Millisekunden, also 36,438356164384 Picosekunden. Kein Wunder, dass mir die Tage jeden Tag länger vorkommen.
Und nun mal ernsthaft gefragt: WAS werfen die sich bei Telepolis eigentlich ein? Welches Zeug rauchen die oder ziehen es sich durch die Nase? Wenn man unbedingt will, kann man die Studie ja erwähnen, darüber einen Artikel veröffentlichen... und auch mal infrage stellen, woher sie denn wissen, auf die Milli bzw. Picosekunde genau, wie lang vor über drei Millionen Jahren ein Tag gedauert hat?
Aber der Titel, der nun aussagt, dass der Klimawandel die Tageslänge erhöht, das ist jetzt schon kein Clickbaiting mehr, das ist entweder ein Zeichen einer psychischen Erkrankung oder Drogenmissbrauchs... sonst fällt mir keine Erklärung ein... Euch vielleicht?
Es war ja ursprünglich mein Plan, sämtliche(!) Artikel aus der Dampfdruck-Presse zu WordPress-Zeiten in Hubzillas Artikel-App zu integrieren.
Da es aber deutlich über 1.000 Artikel sind, ist das vertretbar nur automatisiert zu erledigen...
View article
View summary
Es war ja ursprünglich mein Plan, sämtliche(!) Artikel aus der Dampfdruck-Presse zu WordPress-Zeiten in Hubzillas Artikel-App zu integrieren.
Da es aber deutlich über 1.000 Artikel sind, ist das vertretbar nur automatisiert zu erledigen. Das habe ich ja bereits im Artikel "Basis ist der WordPress Export" erwähnt. Und ich habe inzwischen zwei Skripte für diesen Zweck. Eines, das die Artikel aus einer WXR-Datei in einzelne BBcode-Dateien umwandelt und eines, welches das auch noch mit den Kommentaren zum Artikel macht.
Dann hätte ich die Artikel im korrekten Format. Funktioniert auch prima.
Die Artikel dann aber in die Artikel-App von Hubzilla zu bringen, ist nicht wirklich trivial. Sicher könnte ich die Artikel einzeln über die App erstellen (Copy & Paste), müsste dann aber das Erstellungsdatum noch in der Datenbank korrigieren, damit die Reihenfolge passt. Und die Kommentare hätte ich mit dieser Methode auch noch nicht drin. Das wäre nochmal extra Handarbeit und weitere DB-Manipulation.
Neee... nicht praktikabel.
Dann habe ich überlegt, ob sich die Artikel nicht direkt, ebenfalls mit einem Skript, in die Datenbank einfügen lassen könnten.
Ich bin mir sicher, das geht. Nur... es gibt in der DB-Tabelle "items" ne menge Felder, bei denen ich nicht genau weiß, wie wichtig sie sind und ich müsste mich erst noch drum kümmern, dass die ganzen Id's ordentlich eingetragen würden. Dafür ist die Dokumentation aber einfach zu dünn. Und der Aufwand für solch ein Skript auch sehr groß... und es würde einen weiteren eigenen Entwicklungs-Hub erfordern, damit ich mir nicht meinen Produktiv-Hub durch Zerhackstücken der Datenbank abschieße, wenn ich das Skript teste.
Machbar wäre es, aber der Aufwand (vor allem der Zeitaufwand) ist so groß, dass ich das eher vorerst nicht hinbekomme (ich werde aber... falls ich irgendwann mal Zeit dafür erübrigen kann, an einem solchen Skript arbeiten... könnte ja anderen Nutzern helfen).
Die WordPress-Version der DDP ist ja komplett auf dem "Trockendock". Auf sie hat kein Nutzer mehr Zugriff. Um aber alle Artikel weiterhin erreichbar zu halten (ich lösche nämlich nicht einfach einen Teil der Dampfer-Geschichte), habe ich mit dem Plugin "Simply Static" eine statische Version der DDP erstellt und dieses Archiv konnte ich dann als ZIP-Datei herunterladen. Ich habe es so erstellt, dass die "alte" DDP unter
dampfdruck-presse.de erreichbar sein soll.Also habe ich die Datei lokal entpackt und mit ftp zum Server hochgeladen.
Schnell fiel mir jedoch auf, dass anscheinend nur ca. 1/3. der Artikel auf dem Server landeten. Und so dachte ich, dass ich dann halt aus der ohnehin vorhandenen WXR-Dateien per Importfunktion von Publii eine statische Publii-Version erstelle.
Das klappte auch... aber nur fast! Denn das Skript lädt normalerweise die zu jedem Artikel dazugehörigen Mediendateien (also in der DDP ausschließlich Bilder) herunter und baut sie in die Artikel ein.
Doch der Download klappte nicht, sodass alle Artikel zunächst "bilderlos" erschienen. Ich habe zwar auch diese Mediendateien (
wp-content/uploads) lokal auf meinem Rechner, aber ich hätte nun bei jedem einzelnen Artikel die Bilder manuell von dort aus einfügen müssen. Bei über 1.000 Artikeln und ca. 7.700(!) Grafikdateien eine Wahnsinns-Aufgabe.Weil ich damit also auch nicht weiter kam, dachte ich mir gestern Nachmittag einfach mal: "Frag doch einfach mal Onkel Grok! Vielleicht weiß der einen Rat."
Und tatsächlich gab es auch einen sinnvoll erscheinenden Rat. Ich sollte mir doch einfach die Import-Funktion von Publii sparen und die Artikel mit einem Skript, das er mir lieferte, konvertieren und diese, sowie die Mediendateien in das "input"-Verzeichnis des Publii-Projekts kopieren. Das funktioniert wohl meistens... manchmal... vielleicht auch bei mir.
Nach einige Nachbesserungen am Skript wurde also ein Durchlauf gemacht und es wurden auch die Markdown-Dateien für Publii erzeugt. Nur... Publii hat es nicht in seine Datenbank eingebaut. Weder die Artikel, noch die Mediendateien. Grok hat mit mir dann etliche Versuche durchgeführt, die Artikel doch noch in die Publii-Seite zu bringen, aber nichts hat geklappt. Schließlich "einigten" wir uns darauf, es doch mit dem WordPress-Import von Publii selbst zu machen.
Aber es wurden, wie gesagt, die Mediendateien nicht importiert. Es gab die Fehlermeldung, dass sie nicht heruntergeladen werden können. Und tatsächlich ging das nicht. Jeder Zugriff auf eine Mediendatei (also ein Bild) wurde von Apache mit einem "[url=https://de.wikipedia.org/wiki/HTTP-Statuscode#4xx%E2%80%93Client-Fehler]404[/url]" quittiert. Die Rechte für die Dateien und Verzeichnisse waren ok. Daran konnte es also nicht liegen.
Der eigentliche Grund schien folgender zu sein: Ich hatte die alte WordPress-DDP ja "aufs Trockendock" geschickt... und zwar, indem ich eine
.htaccess Datei mit einer Rewrite-Regel für eine permanente Umleitung der Domain auf die Artikel der Hubzilla-DDP erstellt habe. Und die würde ja auch dafür sorgen, dass der Zugriff auf die Mediendateien nach hub.hubzilla.hu umgeleitet würde, wo diese so nicht vorhanden sind.Also temporär die Rewrite-Regel nach Groks Vorschlag geändert. Aber es gab trotzdem keinen Zugriff.
Ok... dann halt "auf die harte Tour"...
.htaccess gelöscht!Aber trotzdem kein Zugriff. Ich verzweifle noch. Grok serviert mir einige Tests, die ich durchlaufen ließ und die klar zeigten, dass der Zugriff auf Ressourcen schlicht blockiert war. Und ich sollte nun die Apache-Konfiguration modifizieren... auch da bekam ich einige Vorschläge. Doch zu dem Zeitpunkt war meine Geduld echt aufgebraucht und ich habe abgewunken. Vor allem auch, weil ich mir meinen Apache nicht zerkloppen wollte. Die Euroleague-Spiele waren auch schon mit miesen Ergebnissen zu ende (ich habs nebenbei im Augenwinkel verfolgt)... neee... reicht. Dann halt erstmal nicht. Also doch, aber die miese Methode mit dem händischen Einfügen der Grafiken in alle Artikel. Ne Sache für ein paar Monate.
Es war dann schon wirklich spät, nämlich nicht mehr gestern, sondern schon heute.
Aber irgendwie ließ es mir keine Ruhe, dass die Archiv-Datei von Simply Static unvollständig sein sollte. Ich hatte mit dem Tool ja schon Archive der inzwischen eingestellten Projekte "Nebelkrähe" und "ExRaucher-IG" erstellt und die waren vollständig. Da fehlte nix.
Weshalb also denn aber bei der DDP?
Letztlich war mir meine Bequemlichkeit und die Gewohnheit auf die Füße gefallen... in Verbindung mit Software-Unzulänglichkeiten.
Eigentlich bin ich ja sehr gerne mit der Kommandozeile, also im Terminal mit der Shell unterwegs. Aber die ZIP-Datei des statischen Archivs habe ich (ich nutze Plasma/KDE) mit dem KDE-Tool "Ark" geöffnet. Und damit auch lokal entpackt. Was dabei auffiel war, dass zwar alle Verzeichnisse aus dem ZIP-Archiv in Ark angezeigt wurden, aber nicht alle entpackt wurden.
Also habe ich das Archiv auf der Kommandozeile untersucht und festgestellt, dass es intakt ist.
Aber weshalb entpackt Ark es nicht vollständig? Und entpackt es "unzip" im Terminal vielleicht vollständig?
Also ausprobiert. Und tatsächlich waren nun in dem Verzeichnis sämtliche Unterverzeichnisse samt Inhalt vorhanden (laut ls). In Dolphin (dem GUI-Dateimanager) auch... aber wenn ich die Verzeichnisse, die beim Entpacken mittels Ark fehlten, anklickte, bekam ich die Meldung, das Verzeichnis würde nicht existieren. Im Terminal konnte ich aber mit cd in diese Verzeichnisse wechseln... und mir auch die Inhalte z.B. mit cat ausgeben lassen. Nanu? Was soll der Scheiß denn?
Ich hab dann im Terminal mal den MidnightCommander angeschmissen... und da wurde diese Verzeichnisse mit einem führenden Punkt (also quasi als versteckte Verzeichnisse) angezeigt, ich konnte sie aber öffnen und die Inhalte auch anzeigen lassen.
Ein Punkt vornedran? Wieso werden sie mir denn dann in Dolphin angezeigt (ich habe ihn als Default so eingestellt, dass verborgene Dateien und Verzeichnisse nicht im Fenster angezeigt werden)?
Ark hat sie also nicht entpackt, unzip aber schon. Und in Dolphin werden sie dann auch angezeigt, sie lassen sich aber nicht öffnen. Sehr seltsam.
Nun, dann habe ich mal Thunar angeworfen (der Dateimanager von XFCE)... und der verhielt sich genauso wie Dolphin. Und der Dateimanager "Cosmic Dateien" ebenfalls. Ach... ich hab ja auch noch PCManFM, den Dateimanager von lxqt auf Tasche. Also auch mal ausprobieren! Und siehe da... da wurden die "seltsamen" Verzeichnisse nicht nur angezeigt, sondern ich konnte sie auch öffnen und auf die Inhalte zugreifen.
Noch mehr Fragezeichen über meinem Kopf!
Ok... wenn die Verzeichnisse und deren Inhalt vorhanden sind, dann könnte ich es ja ausprobieren, das mit unzip entpackte Archiv per ftp hochzuladen. Nur... in FileZilla wurden die Dateien wieder nicht angezeigt. Aaaargh!
Ob Grok schon schläft? Nein, schläft nicht. Ich habe dann nach möglichen Ursachen für dieses Verhalten, das ich mir nicht erklären konnte, gefragt und mir wurden dann wieder etliche Tests vorgeschlagen, die ich durchgeführt habe. Z.B. ein Test darauf, ob die Verzeichnisnamen führende unsichtbare Leerzeichen haben oder ob die Verzeichnisnamen ungewöhnliche Sonderzeichen (die nicht angezeigt werden) enthalten. Alles negativ. Schließlich bekam ich die Info, dass es womöglich daran liegen könnte, dass die Verzeichnisnamen sehr lang sind und viele Bindestriche enthalten, womit Dolphin und etliche andere Dateimanager anscheinend nicht klarkämen. Ob dem so ist? Keine Ahnung. Es sieht aber zumindest danach aus. Klingt zumindest plausibel.
Mir wurde dann vorgeschlagen, die ftp-Funktion von PCManFM für den Upload zu nutzen, wenn dieser Dateimanager alles richtig anzeigt und den Zugriff erlaubt. Es war mittlerweile drei Uhr morgens und ich habe mich artig bedankt und den Versuch auf "nach dem Aufstehen" verschoben.
Und heute Vormittag hab ich das dann gemacht. Hat lange gedauert (die Mediendateien haben echt viel Zeit verbraucht... kein Wunder bei der Menge an Grafikdateien), aber irgendwann war es erledigt. Und vor allem ist das Archiv unter dampfdruck-presse.de jetzt wirklich vollständig.
Einen Nachteil hat das statische Archiv von Simply Static aber noch! Die Suchfunktion funktioniert nicht! Zumindest nicht bei der kostenlosen Variante, die ich verwendet habe. Es gibt zwar ein Suchfeld, aber das bringt keine Ergebnisse.
Allerdings habe ich ein Skript, das einen Index des DDP-Archivs erzeugt, der dann über ein Webformular durchsuchbar ist. In der Seitenleiste der DDP (Hubzilla) gibt es nun einen Link "DDP-Archiv durchsuchen"
der zu einem Suchformular führt, mit welchem man das Archiv bis zu den Anfängen im Jahr 2013 durchsuchen kann.
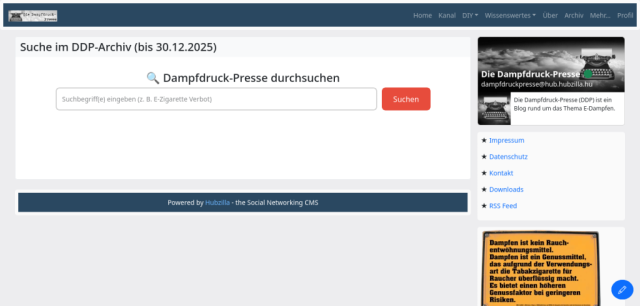
Also... auch ältere Artikel sind und bleiben verfügbar. Eine Sache, die mir sehr wichtig ist und die auch jetzt, nach der Umstellung der DDP auf Hubzilla als CMS erhalten bleibt.
Was ne nervenaufreibende Nacht... was ein K(r)ampf... aber es ist geschafft!
Anlässlich der groooßen An- bzw. Verkündigung des revolutionären, einzigartigen, neuen und höchst offfffizielllllen "Share to Mastodon Buttons" bin ich über eine echt tolle Möglichkeit gestolpert, einen "Share to FEDIVERSE Button" auf den eigenen Seiten einzubauen...
View article
View summary

Anlässlich der groooßen An- bzw. Verkündigung des revolutionären, einzigartigen, neuen und höchst offfffizielllllen "Share to Mastodon Buttons" bin ich über eine echt tolle Möglichkeit gestolpert, einen "Share to FEDIVERSE Button" auf den eigenen Seiten einzubauen. Ich bin im ersten Teil "Teile im Fediverse?" nur auf share2fedi eingegangen und hatte nicht nach Alternativen geschaut.
Share2fedi hat ja einen "Nachteil" (was man so "Nachteil" nennen mag)... man greift auf eine fremde Ressource zu. Der Code gibt zwar keinerlei Hinweise auf irgendeine Datenverarbeitung durch den Betreiber her, und man kann den Dienst ja auch selbst hosten (der Code steht als Open Source auf github unter der AGPL3-Lizenz zur Verfügung). Selbst hosten... also einen Dienste-Service auf dem Server installieren... schon was umständlich und mit der Notwendigkeit, einen Reverse Proxy zu nutzen.
Aber es gibt da eine echte Alternative, die wesentlich leichtgewichtiger daherkommt: Fediverse Sharing Button von Stefan Bohacek
Um diesen "Button" einzubauen, braucht man nur ein Snippet in die eigene Seite einfügen... und schon ist er betriebsbereit.
Im Repo zu diesem Button liegt das Snippet zum Kopieren vor. In diesem Fall wird zwar auch auf externe Ressourcen zugegriffen, der Klick auf den Button nimmt aber keinen Umweg über einen fremden Dienst, wie es bei share2fedi der Fall ist. Die eine externe Ressource sind Grafiken mit den Logos verschiedener Fediverse-Dienste (mit denen der Button funktioniert). Bei dem Button ist es nämlich so, dass nach dem Eingeben der URL des genutzten Fediverse-Dienstes das Logo der Fediverse-Software automatisch auf dem Button angezeigt wird. Und es wird auf den fediverse-info Server zugegriffen, die node-info Daten zu den Servern zu bekommen, ohne die eigentlichen Instanzen mit Anfragen zu belasten. Es wird also nirgendwo etwas gespeichert und es fließen auch keine Daten zu dubiosen Diensten ab.
Also... gespeichert wird schon etwas (kann man aber abstellen): die eingegebene URL der Instanz und die Bezeichnung der darauf laufenden Fediverse-Software.
Das allerdings wird nicht irgendwo gespeichert, sondern beim Nutzer selbst lokal im localStorage-Speicher. Und man kann es auch verhindern, wenn man unbedingt jedes Mal wieder neu die Domain des Fediverse-Dienstes eingeben möchte.
Das Snippet, das auf der Webseite des Projekts zur Verfügung steht, nutzt die Ressourcen (die Icon-Dateien, eine Javascript-Bibliothek und eine CSS-Datei), die der Entwickler auf seinem eigenen Server zur Verfügung stellt. Man kann diese Dateien aber auch auf dem eigenen Server ablegen und von dort aus verwenden.
Dafür lädt man das Verzeichnis
fediverse-share-button/icons samt enthaltener Grafiken, sowie die Dateien script.min.js und styles.min.css in ein Verzeichnis auf dem eigenen Server (das Verzeichnis muss öffentlich zugreifbar sein, damit der Button auch bei jedem funktioniert) und ändert die Referenzen im Snippet auf die eigene URL.Der Button funktioniert aktuell mit Diaspora, Firefish, Friendica, Glitch-soc, Hometown, Hubzilla, Lemmy (aktuelle Versionen), Mastodon, Misskey und Sharkey. Also mit etlichen Diensten des Fediverse... ist ja auch ein Fediverse-Share-Knopf und kein Du-sollst-keine-anderen-Götter-haben-neben-Mastodon-Button. Der funktioniert dann auch bei Besuchern unserer Webseite, die keinen Mastodon-Account haben, aber sehr wohl einen bei den anderen unterstützten Diensten.
Ich persönlich würde IMMER diesen Button empfehlen, anstatt eine sehr große Zahl Fediversenutzer durch einen einseitigen Button auszugrenzen.

Heute trinke ich mir zur Feier des Tages mal einen Pálinka (was selten vorkommt)...
Auf den Tag genau zehn Jahre ist es nun her (28. Februar 2016), dass ich meine ersten Schritte mit Hubzilla gemacht habe...
View article
View summary

Heute trinke ich mir zur Feier des Tages mal einen Pálinka (was selten vorkommt)...
Auf den Tag genau zehn Jahre ist es nun her (28. Februar 2016), dass ich meine ersten Schritte mit Hubzilla gemacht habe. Fragt mich bitte nicht nach der genauen Version... muss irgendwas um die 1 herum gewesen sein. Damals war das Hubzilla-Universum nur das Grid, denn ActivityPub war noch nicht implementiert. Ich hatte mir dann einen Hub ausgesucht und wollte mich registrieren, aber das hat nicht wirklich geklappt, weshalb ich einen eigenen Hub auf Uberspace installierte, was aufgrund einer im Netz vorhandenen Anleitung sehr einfach war. So war ich von Anfang an also auch Hubzilla-Admin.
Am 13. März 2016 veröffentlichte ich dann auch einen ersten Artikel zu Hubzilla: Schon wieder was neues? Hubzilla.
Denn ich war begeistert von den Möglichkeiten dieses Netzwerks und der Software. Und ich bin seit dem auch nie wieder wirklich von Hubzilla weggekommen. Zwar habe ich etliche Dienste als "Gast" auf fremden Instanzen, aber sehr oft auch auf selbst gehosteten Instanzen ausprobiert, aber es hat mich immer wieder zu Hubzilla zurückgezogen... und ich hatte auch immer(!) einen eigenen Hub am Laufen.
Anfangs hatte ich viele Kontakte zu Diaspora-Nutzern (weil Hubzilla die Verbindung durch ein Addon erlaubte) und zu etlichen Hubzilla-Kanälen. Die große Welt des Fediverse erschloss sich dann im Sommer 2017, als Hubzilla –zusätzlich zum Protokoll Zot – auch noch ActivityPub implementierte, was es möglich machte, sich mit den (damals noch wenigen) Diensten zu verbinden, die auch schon ActivityPub verwendeten (Pleroma war das wohl und an Herbst 2017 kam dann Mastodon hinzu, auf welches viele GNU Social Nutzer umgestiegen waren). Von da an ging die Post ab.
Aktuell habe ich mit meinem Hauptkanal Der Pepe (Hubzilla) ⁂ 114 Zot6/Nomad-Verbindungen, zwei RSS-Verbindungen und 212 ActivityPub-Verbindungen. Diaspora-Kontakte habe ich keine mehr.
Über die Jahre habe ich mir einiges an Wissen zu Hubzilla angeeignet und versuche, dieses Wissen auch weiterzugeben und auch für Einsteiger möglichst verständlich aufzubereiten.
Im Sommer 2024 habe ich dann begonnen, die hubzilla-interne Hilfe, also die eingebaute Dokumentation grundlegend zu überarbeiten (sie war wirklich sehr veraltet) und neu aufzubauen. Nebenbei pflege ich auch noch meine Hubzilla KnowledgeDB, die Informationen noch einmal anders aufbereitet und auch Themen behandelt, die im Manual nicht oder nur in beschränktem Umfang vorkommen. Und für die Nutzung von Hubzilla als Content Management System habe ich auch eine Online-Dokumentation begonnen, die hoffentlich helfen kann, auch andere Dinge, als nur Social Media mit Hubzilla zu machen.
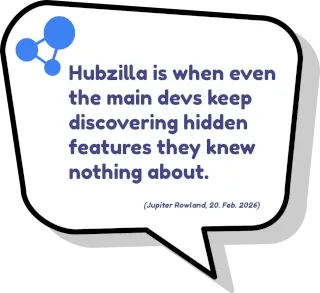
Und obwohl ich nun schon so lange "mit Hubzilla rummache", entdecke ich trotzdem immer wieder Möglichkeiten und Funktionen, die ich bislang nicht kannte. Das geht übrigens nicht nur mir so, sondern sogar die Entwickler stolpern ab und an über Dinge, die ihnen vorher unbekannt waren. Gerade kürzlich entdeckte Harald Eilertsen (einer der Entwickler) einen "Experten-Modus" für die Warteschlangenverwaltung (was natürlich sofort in der KnowledgeDB landete und auch ins Manual kommt), was Jupiter Rowland zu einem Kommentar veranlasste, der jetzt auf meiner Kanalseite prangt:
Hubzilla is when even the main devs keep discovering hidden features they knew nothing about.
Quelle: Jupiter Rowland auf Hubzilla
Ende 2024 wurde ich dann Mitlied der Hubzilla Association, der Organisation, welche die Entwicklung, Förderung und Verbreitung von Hubzilla unterstützt und bei der Pflege der Dokumentation und der Website hilft. Sie betreibt auch die Projekt-Webseite hubzilla.org und verschiedene Support-Kanäle, wie z.B. das "berühmte" (und absolut empfehlenswerte) Hubzilla Support Forum.

Auch wenn Hubzilla heute immer noch "unter dem Radar" fliegt, ist es das System meiner Wahl. Ich schätze es wegen der kontinuierlichen und unaufgeregten Weiterentwicklung. Gerade hat z.B. ein echtes Hammer-Feature Einzug gehalten: die Integration von Collabora über das neue WOPI-Addon. Damit ist die Bearbeitung von Cloud-Inhalten extrem komfortabel geworden und eine Zusammenarbeit wesentlich einfacher, als über den Umweg z.B. über die Wiki-Funktion. Fehler werden schnell ausgemerzt und der Support ist in der wundervollen Gemeinschaft rund um Hubzilla einfach hervorragend.
Im Rückblick waren es zehn aufregende Jahre, Jahre die Spaß gemacht haben und Jahre, die Lust auf weitere zehn Jahre mit Hubzilla machen.
Und falls jetzt jemand neugierig geworden ist: Probiert es einfach einmal aus... Join Hubzilla
Oktober vergangenen Jahres habe ich begonnen, ein kleines "Buch" über die Nutzung von Hubzilla als CMS zu schreiben. Inzwischen ist es vorerst fertig. Wobei "fertig" nicht stimmt, denn es wird nach und nach weitergeführt und um weitere Kapitel und Themen erweitert. Aber es ist nun auf einem Stand, der für Nutzer hilfreich sein sollte...
View article
View summary

Oktober vergangenen Jahres habe ich begonnen, ein kleines "Buch" über die Nutzung von Hubzilla als CMS zu schreiben. Inzwischen ist es vorerst fertig. Wobei "fertig" nicht stimmt, denn es wird nach und nach weitergeführt und um weitere Kapitel und Themen erweitert. Aber es ist nun auf einem Stand, der für Nutzer hilfreich sein sollte.
Es ist grundsätzlich erst einmal ein "Online-Buch" und unter der URL https://cms.hubzilla.hu/ zu finden. Allerdings habe ich auch eine PDF-Version erstellt, die zum Download zur Verfügung steht. Dieser PDF-Version wird immer, wenn einiges dazugekommen ist, ebenfalls aktualisiert.
Schaut es Euch einfach einmal an...
Hier das derzeitige Inhaltsverzeichnis:
Demnächst wird es auf jeden Fall ergänzt, denn mit der Veröffentlichung von Hubzilla 11.0 hat ein echter Gamechanger Einzug gehalten. Es gibt nun das Addon "WOPI", welches es ermöglicht, die Cloud von Hubzilla mit Collabora Office zu nutzen. Streng genommen ist Cloud-Funktionalität zwar nicht zwingender Bestandteil eines CMS, sie wird aber immer öfter bei solchen Systemen angeboten und die diesbezügliche Erwartungshaltung nimmt zu, weshalb die Cloud im Buch ebenfalls entsprechend gewürdigt wird. Insbesondere, weil sie auch für das Bereitstellen statischer Webseiten genutzt werden kann.
Zum Thema Cloud kommt, zusätzlich zur Collabora-Nutzung, auch noch ein wenig mehr. Ich werde beschreiben, wie man eine automatische Synchronisation des Cloud-Verzeichnisses mittels "Rclone" oder mit einem Python-Programm realisieren kann, so dass es sich anfühlt wie Nextcloud mit dem Synchronisierungs-Tool.
Über Anregungen und Themenwünsche freue ich mich natürlich auch. So kann das Buch weiter wachsen.
Code-Schnipsel, Tools, Stylesheets, Blöcke und Webseiten-Vorlagen zum Buch können aus meinem Repository https://codeberg.org/derpepe/hubzilla_website_building heruntergeladen werden.
Sharing für Fediverse-Dienste, also ein "Share im Fediverse Button" ist kein ganz triviales Ding.
Das Problem besteht darin, dass das Fediverse dezentral ist...
View article
View summary
Sharing für Fediverse-Dienste, also ein "Share im Fediverse Button" ist kein ganz triviales Ding.
Das Problem besteht darin, dass das Fediverse dezentral ist. Ein "Teile bei X", "Teile bei Facebook", etc. Button hat es leicht. Alle diese zentralisierten Dienste laufen auf einem Server bzw. sind unter einer einzigen URL erreichbar. Für "X" muss "
x.com" aufgerufen werden, für "Facebook" entsprechend "www.facebook.com" etc. Damit ist man an der richtigen (wenn man es denn so empfindet) Stelle.Es gibt aber nicht "die eine URL" für das Fediverse. Jeder, der z.B. auf eine Webseite mit einem Inhalt stößt, den er gerne im Fediverse teilen möchte, kann und wird auf einer anderen Instanz sein... und dann auch noch in der Regel bei einem anderen Fediverse-Dienst. Und jede Instanz hat eine andere URL. Der Betreiber der Webseite weiß aber nicht, welchen Dienst der Besucher verwendet. Und womöglich verwendet dieser ja sogar mehrere verschiedene Fediverse-Dienste, die natürlich unter unterschiedlichen URLs erreichbar sind. Mit welcher er den Inhalt nun teilen möchte, kann der Website-Betreiber natürlich auch nicht wissen. Dilemma!
Das ist der Grund, weshalb man fast nirgendwo einen "Teile im Fediverse Button" findet. Und es ist auch ungerecht, den Betreiber dafür zu schimpfen.
Es gibt aber eine recht gut einsetzbare Lösung dafür. Sie ist weit entfernt davon, perfekt zu sein und unterstützt derzeit auch bei weitem nicht alle Fediverse-Dienste. Aktuell werden Mastodon (inklusive Hometown, Fedibird, GlitchCafé), Misskey (inkusive Calckey/Firefish, FoundKey und Meisskey, nicht jedoch Sharkey, Iceshrimp und Iceshrimp.NET), Friendica, Hubzilla und GNU Social unterstützt. Gotosocial, Mitra, Pleroma/akkoma und die meisten anderen Dienste sind derzeit leider (noch) nicht unterstützt.
Aber immerhin, das ist schon eine ganz gute Auswahl fürs Erste.
Die Lösung heißt "Share2Fediverse" und ist unter "s2f.kytta.dev" verfügbar. Ein Button, der ein "Teile im Fediverse" mit diesem Dienst anbietet, nimmt einen kleinen Umweg diese Seite und der Besucher muss dort die URL (Webadresse) der Fediverse-Instanz angeben, bei der man über einen Account verfügt. Dieser Zwischenschritt muss sein, weil Fediverse-Dienste auf unzählige Server mit unterschiedlichen Webadressen aufgeteilt ist.
Um es nun ganz einfach zu machen... auch und gerade für Webseiten-Besitzer ohne große technische Kenntnisse, habe ich einfach einen kurzen „Schnipsel“ HTML geschrieben, den man einfach unter seinen Beitrag/Artikel etc. packen muss. Er zeigt einen Fediverse-Button an und führt zu besagter Seite, wobei Titel und Link des Beitrags übernommen werden. Hier gibt nun der Leser die Adresse seines Fediverse-Dienstes ein und kann den Beitrag teilen:
<p><a href="https://s2f.kytta.dev/" onclick= "location.href=this.href+'?text='+document.title+' '+window.location; return false;"><img src="https://pepecyb.hu/files/share_fediverse.png" alt="Teile im Fediverse" title="Teile im Fediverse"/></a></p>Das funktioniert z.B auch prima mit WordPress. Dafür erstellt man einfach einen HTML-Block mit diesem Code und speichert ihn als Vorlage. So kann man ihn mit zwei Klicks unter jeden Artikel packen.
Natürlich besteht rein technisch die Möglichkeit, dass "s2f.kytta.dev" gewisse Daten des Nutzers abgreift. Stimmt! Aber es ist eher unwahrscheinlich. Zumal der Quelltext des Dienstes in einem Git-Repository einsehbar ist: https://github.com/kytta/share2fedi.
Als weitere Alternative könnte man in Erwägung ziehen, Share2Fedi einfach auch selbst zu hosten. Das sollte sogar kostenneutral möglich sein, wenn man es mit Vercel macht... aber möchte man, dass die eigenen Leser über einen Server in den USA geleitet werden? Also ich nicht! Man kann Share2Fedi aber auch auf einem eigenen Server (mindestens VPS) installieren... doch das ist dann auch wieder etwas für Spezialisten.
Es gibt auf jeden Fall eine Möglichkeit, einen "Teile im Fediverse Button" einzusetzen, auch wenn er mit einigen wenigen Einschränkungen behaftet ist.
Mein Schnipsel ist zumindest einfach... mehr soll er auch nicht sein.
Ich habe ihn selbst verwendet, als ich meine Blogs noch mit WordPress betrieben habe.
Auf die Grafik des Buttons ist man übrigens nicht festgenagelt.
Da kann man auch die URL zur Grafik eines anderen Buttons einsetzen....was die ganze Sache nun soll?
Seit ein, zwei Tagen tauchten mehr und mehr Postings in meinem Stream auf, in welchen es um das "Forkiverse" ging.
View article
View summary

...was die ganze Sache nun soll?
Seit ein, zwei Tagen tauchten mehr und mehr Postings in meinem Stream auf, in welchen es um das "Forkiverse" ging.
Forki... Was?
Also das Fediverse kenne ich ja... und dann kenne ich noch die Forkeys, also Fediverse-Software, die als Forks oder Forks von Forks oder... na ja... Forks halt von Misskey entstanden sind (also Sharkey, Calckey - Firefish, Iceshrimp und wie sie alle heißen)... aber was ist denn das "Forkiverse" und weshalb wird darüber so viel geschrieben?
So rein vom Namen klingt es so, als würde da jemand das Fediverse "forken" wollen, also ein neues, abgeleitetes, aber dennoch anderes Fediverse schaffen.
Aber ist dem wirklich so? Und braucht es sowas? Und möchte irgendwer sowas? Und überhaupt...
Wirklich fundierte Informationen darüber, was das "Forkiverse" nun ist, findet man nicht wirklich.
Es gibt eine Mastodon-Instanz (also schonmal nix mit "Fork") mit dem Namen "Forkiverse" unter der Domain theforkiverse.com. Und da steht dann auch ein Satz:
Building a better internet with your friends from Hard Fork and Search Engine.
Also...
Gemeinsam mit Ihren Freunden von Hard Fork und Search Engine ein besseres Internet schaffen.
Wer oder was sind jetzt "Hard Fork" und "Search Engine"? Und wer sind diese Freunde, die meine Freunde sein sollen und mit mir ein "besseres Internet" aufbauen möchten?
Mehr Infos findet man unter der Domain zunächst nicht. Außer, dass es (stand 12. Januar 2026) um die 3.200 Accounts auf der Instanz gibt und die Instanz von einem gewissen Kevin Roose betrieben, adminstriert, moderiert wird.
Wer ist das denn nun schon wieder? Ein amerikanischer Journalist ist es. Kein Wunder, dass mir der Name nicht geläufig ist. Und er arbeitet irgendwie auch für die New York Times. Da zeichnet er auch für den Podcast "Rabbit Hole" verantwortlich und er ist außerdem Co-Moderator eines weiteren NYT-Podcasts mit dem Namen "Hard Fork".
Aaahhh... jetzt... "Hard Fork" ist also ein NYT-Podcast, der von Kevin Roose und einem gewissen Casey Newton moderiert wird... und in welchem es um die "Radikalisierung des Internets" geht.
Der Name Casey Newton taucht im Zusammenhang mit "Forkiverse" auch immer mal auf. Und wer ist das nun? Na auch ein amerikanischer Journalist.
Gräbt man dann in den Infos zu diesen Protagonisten und den Podcasts stößt man irgendwann auch auf "Search Engine", was ein Podcast von CBC bzw. TVOntario ist, ursprünglich moderiert von einem Jesse Brown, jetzt wohl von einem gewissen PJ Vogt, dessen Name auch im Zusammenhang mit dem "Forkiverse" immer wieder fällt.
Na ok... das mit "meinen Freunden von Hard Fork und Search Engine" war wohl nix. Hab da keine Pfroinde. Egal...
Und die wollen jetzt ein "besseres Internet" aufbauen. Stellt sich also die Frage, was denn ein "besseres" Internet auszeichnen soll.
Liest man die wenigen (habe nur zwei mit "etwas Fleesch uffe Rippen" gefunden) Artikel zum "Forkiverse", bekommt man eine grobe Vorstellung, was es damit auf sich haben soll. [1] [2]
Also... das "Forkiverse" ist ein Kind dreier Podcaster: Kevin Roose, Casey Newton und PJ Vogt. Sie wollen ein "besseres" Internet schaffen, wobei "besser" von ihnen nicht wirklich definiert wird. "Besser" halt! Und wer würde das nicht wollen, denn schließlich soll ja "die derzeitige Version des Internets" laut ihrer Ansicht die "wohl die schlechteste, die es je gab" sein.
Also... na ja, so richtig ein neues Internet trauen sie sich dann doch eher nicht zu. Ihre Vision ist ein "besseres Soziales Netzwerk". Das wollen sie aber mal machen. Und dafür nutzen sie Mastodon. Ist ja prima! Aber damit schaffen sie ja nichts Neues, denn Mastodon gibt es nun schon seit dem 16. März 2016 und das Fediverse, dessen Teil es ist, bereits seit dem 18. Mai 2008. Was sie geschaffen haben, ist eine weitere Mastodon-Instanz zu den bis dahin (Zahlen laut FediDB) 9.181 anderen Mastodon-Instanzen bzw. eine weitere Fediverse-Instanz zusätzlich zu den bis dahin 42.906 Fediverse-Instanzen.
Nun ist aber auch ihre Instanz Teil des Fediverse (und deshalb spülte es mit Postings von dieser Instanz in meinen Stream) und damit war es das dann auch schon mit dem vermeintlich "besseren" Sozialen Netzwerk nach ihren Vorstellungen. Denn sie haben ja keinen Einfluss darauf, was im gesamten Fediverse so alles passiert.
Hätte sie einen wirklichen "Reinraum" erschaffen wollen, hätten sie ihre Instanz entweder deföderieren müssen oder womöglich gleich eine andere Social-Network-Anwendung (sowas wie Oxwall, HumHub, Elgg etc.) oder eine Foren-Software nutzen können. Solange aber ihre Forkiverse-Instanz im Fediverse drinhängt, sind sie Teil dieses großen Netzwerks und nur beschränkt in der "Reinhaltung".
Der Artikel von Maho Pacheco offenbart auch, dass weder er, noch die drei Forkiversisten das Fediverse an sich verstanden haben. Man benötigt nämlich für eine Art Community, wie sie sich eine vorstellen, keine eigene Instanz. Und es ist auch nicht im Sinne der Dezentralisierung, nun möglichst viele Gleichgesinnte auf eine einzige Instanz zu locken (mit einem irgendwie gearteten Heilversprechen à la "besseres Internet").
Und, auch wenn ich viele hier vielleicht enttäuschen mag: Es ist und bleibt völlig egal, welche Instanz Ihr für Euren Account auswählt. Zumindest themenbezogen oder in Bezug auf die Region. Die Instanz-Regeln können einen Ausschlag für die Auswahl geben oder die Zuverlässigkeit (Verfügbarkeit). Aber eine "Angler-Instanz" ist auch für Nicht-Angler genauso gut zu nutzen, wie eine andere Instanz und sie bringt auch Angelbegeisterten keine wirklichen Vorteile. Lediglich die lokale öffentliche Timeline enthält dann wahrscheinlich mehr Angler. Aber wolltet Ihr nicht Algorithmen loswerden? Wolltet Ihr nicht, dass Euch nichts ungefragt in die Timeline gespült wird. Ist der lokale Stream wirklich so wichtig?
Das Fediverse macht ein klein wenig Mühe. Damit Angler als Angler gefunden werden, müssen sie diese Info halt in ihrem Profil unterbringen. Oder man sucht, auch wenn man einen Account bei einer anderen Instanz hat, einfach mal eine Angler-instanz auf und schaut sich deren lokale Zeitleiste an, um auf Angelfreunde zu stoßen. Himmel! Wenn Ihr war vorgekaut haben wollt, müsst Ihr halt bei den Walled Gardens bleiben und Euch von einem undurchsichtigen Algorithmus vor den Latz knallen lassen, was dieser meint, dass es Euch interessiert.
Und der Titel ihres Projekts ist jetzt auch nicht unbedingt sehr geschickt gewählt. "Forkiverse" klingt nämlich erstmal so, als gibge es wirklich um eine Abspaltung von Fediverse... was es aber ja eben wieder nicht ist, weil ins Fediverse eingebunden. Der Name weckt Erwartungen, die das Projekt nicht erfüllen kann. Ob das jetzt ein Versehen aus Unwissenheit war oder ob es eher eine Art Marketing-Gag sein sollte... keine Ahnung. Sympathien kann man so nicht sameln. Und eine möglichst große Instanz anzustreben widerspricht sowohl dem dezentralen Gendanken des Fediverse und macht alle Bemühungen, die Nutzer auf möglichst viele Instanzen zu verteilen, zunichte.
Für mich sieht die ganze Sache wie eine mächtige Schaumschlägerei aus... nicht mehr und nicht weniger. Und wenn der Hashtag in absehbarer Zeit nicht mehr so wild durch die Gegend geworfen wird, dann lösche ich ihn auch wieder aus meinem Filter.
[1] The Forkiverse Experiment and Why Instance Choice Matters (arch)
[2] The Fediverse Experiment (arch)
Bei allen Überlegungen, wie ich es denn letztlich realisieren möchte, läuft es in fast allen Fällen darauf hinaus, dass ich die Inhalte des WordPress Blogs exportieren muss...
View article
View summary

Bei allen Überlegungen, wie ich es denn letztlich realisieren möchte, läuft es in fast allen Fällen darauf hinaus, dass ich die Inhalte des WordPress Blogs exportieren muss. Auf welche Weise ich diese dann verarbeite, hängt vom gewählten Weg ab.
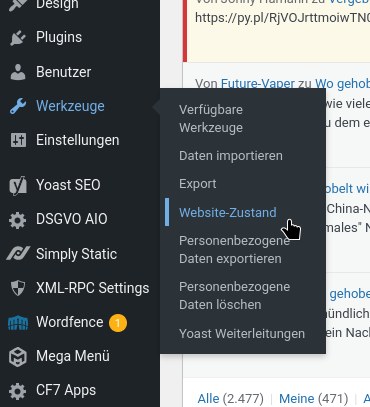
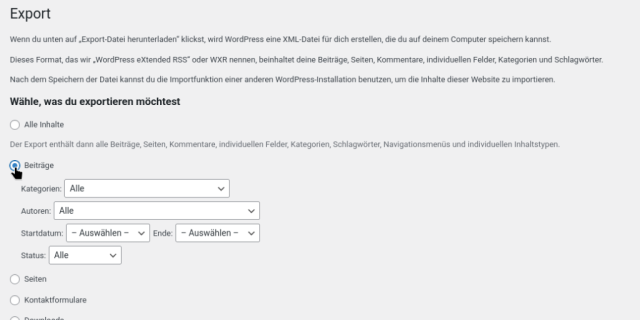
Die Export-Funktion von WordPress ist ganz einfach zu benutzen. Man findet sie in der Seitenleiste unter dem Menüpunkt "Werkzeuge".

Man kann dort alle möglichen Inhalte exportieren, ja sogar alle auf ein Mal. Nun, alle brauche ich nicht. Ich brauche tatsächlich nur die Beiträge (inklusive der Kommentare). Und weil in der DDP so viele Beiträge existieren und die Sicherungsdatei extrem groß werden würde, habe ich mich entschieden, je einen Export für jeweils ein Jahr zu erzeugen.


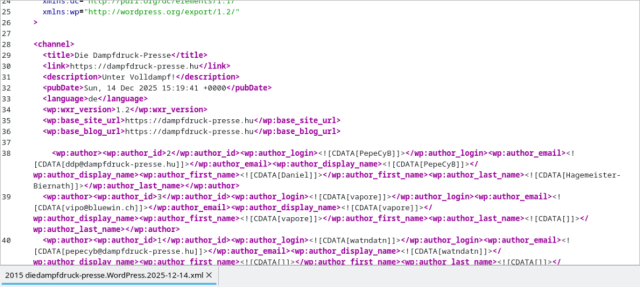
Und dann habe ich eine Export-Datei (die Sicherungsdateien werden von WordPress als WXR-Dateien – für WordPress eXtended RSS - bezeichnet) im XML-Format.

Diese Dateien sind für Publii und dessen Import-Funktion direkt nutzbar. Allerdings werden nur die Artikel selbst importiert. Die Kommentare bleiben unberücksichtigt.
Ansonsten sind die WXR-Dateien aber nicht wirklich für die direkte Nutzung geeignet. Um sie z.B. für die Artikel-App von Hubzilla zu verwenden, muss man die eigentlichen Artikel extrahieren und ins BBcode-Format umwandeln. Und die Kommentare müssen auch (am besten separat) extrahiert werden.
Per Hand ein riesiger Aufwand. Dafür müssen Helfer-Skripte her... aber dazu später mehr (sind schon in Arbeit).
Lediglich für die Variante mit einem externen statischen Archiv werden die Exportdateien nicht benötigt (schadet aber auch nicht, welche als Backup zu haben). Ich würde dafür Simply Static nutzen, mit dem ich schon gute Erfahrungen gemacht habe.
Conversation Features
Loading...
Loading...